 Оксана Хромова
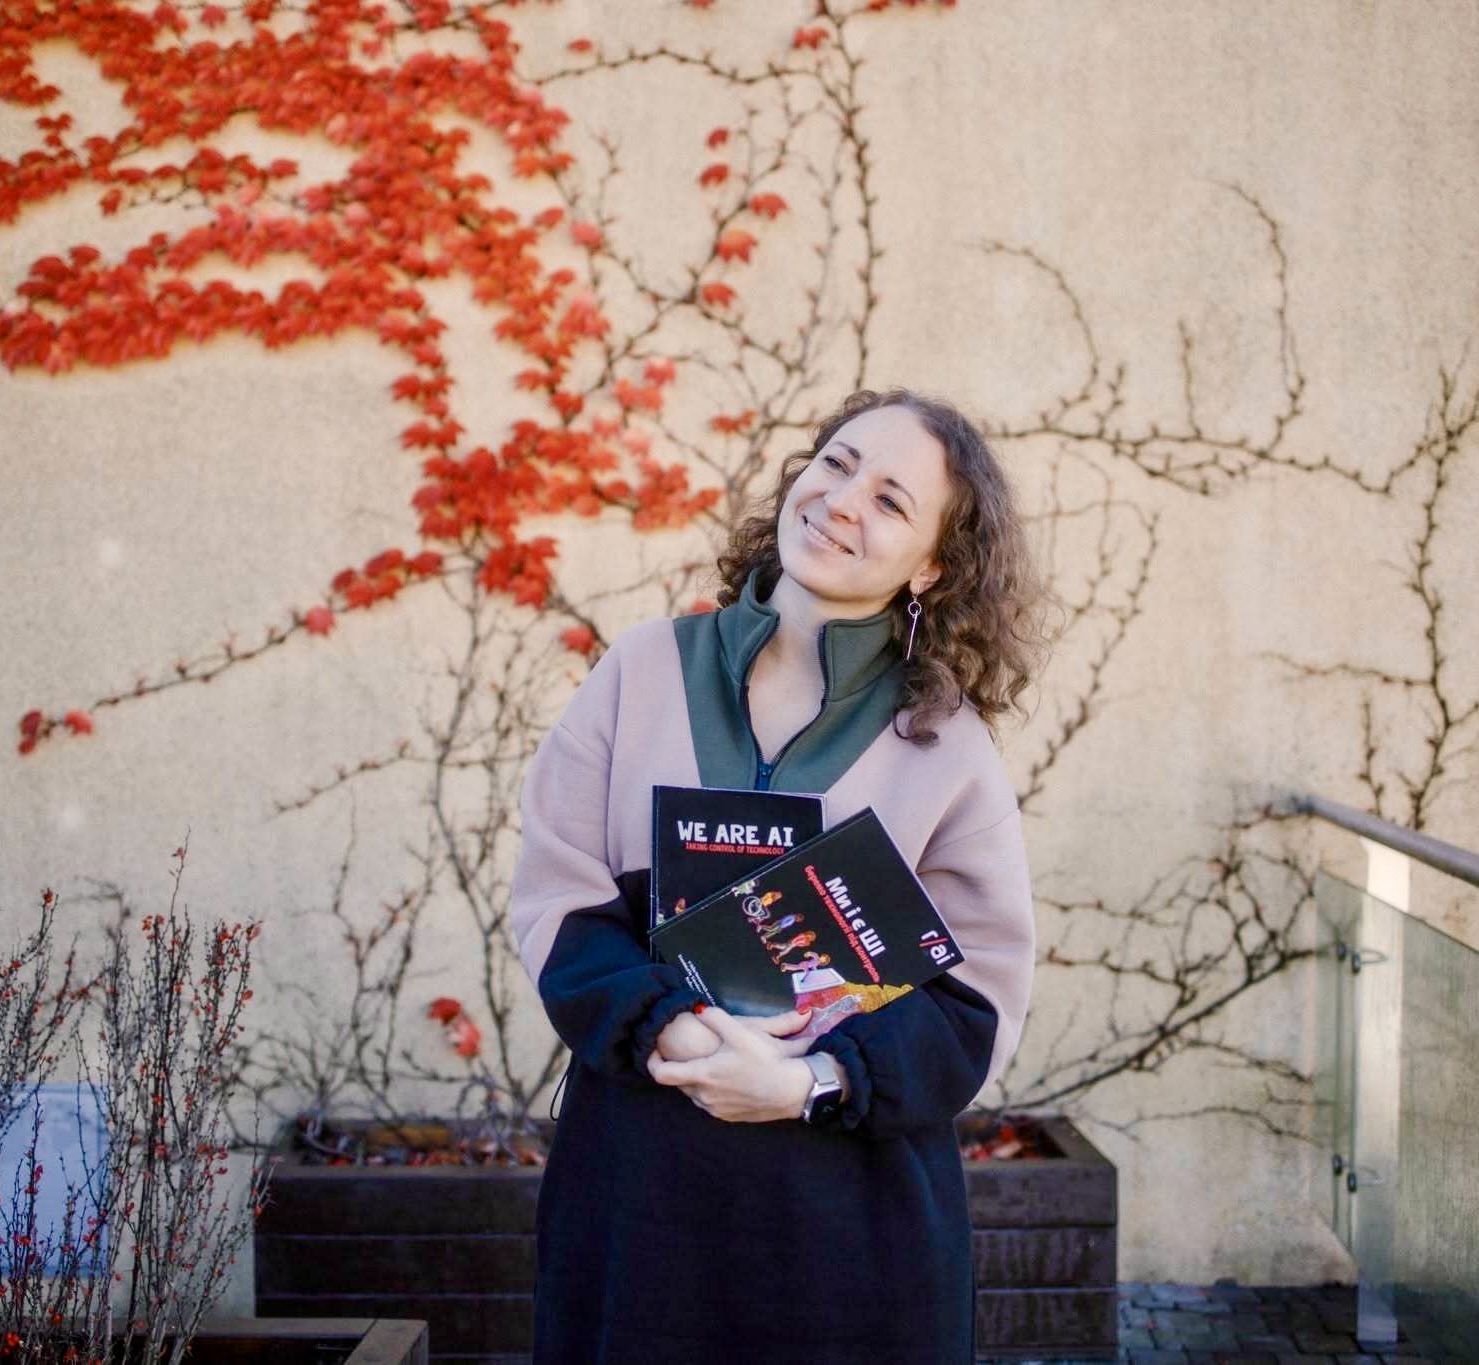
Штучний інтелект уже впливає на те, яку інформацію ми бачимо, як шукаємо роботу, отримуємо фінансові й медичні послуги. Та разом із людськими знаннями алгоритми успадковують і людські упередження, зокрема гендерні.
Тетяна Захарченко — кандидатка фізико-математичних наук, директорка Центру для даних, ШІ та суспільства Українського католицького університету й координаторка програми Responsible AI for Ukraine. Нині разом із командою вона бере участь у Women Led Science та працює над проєктом FairForget. Його мета — з’ясувати, чи справді мовна модель позбувається стереотипу, коли її вчать його «забувати», і чи не з’являються при цьому нові упередження.
В інтерв’ю Тетяна розповіла, як алгоритми можуть відхиляти жіночі резюме, чому спроба позбавити ШІ одного стереотипу може створити інший і навіщо досліджувати упередження саме українською.
Ви починали з досліджень у лінійній алгебрі. Чому згодом вирішили зосередитися на відповідальному штучному інтелекті?
В Україні я не бачила, як займатися фундаментальною математикою й водночас заробляти на життя. У мене були пропозиції наукової карʼєри за кордоном, але мій наречений був військовим, і я вирішила залишитися. Науку тоді покинула.
Пішла в освітню компанію, яка готувала до стандартизованих тестів, зокрема ЗНО. Ми збирали дані й перевіряли, наскільки ефективно навчаємо. У якийсь момент моїх навичок стало недостатньо, тому пішла навчатися на програму зі статистики та науки про дані в Массачусетському технологічному інституті.
Фінальні іспити припали на початок повномасштабної війни. Для них потрібен був безперервний інтернет, тому я поїхала до Львова. Випадково потрапила на каву в УКУ — і, власне, там залишилася.
Згодом долучилася до проєкту «Відповідальний штучний інтелект для українських студентів» у співпраці з Нью-Йоркським університетом. Так і занурилася в дослідження справедливості моделей ШІ.
Що сьогодні означає «відповідальний ШІ» і чому недостатньо, щоб система просто добре виконувала поставлене завдання?
Коли говоримо про відповідальний ШІ, важливо, як ми будуємо моделі, що в них закладаємо і як проєктуємо для використання. Я працюю саме з ядром моделей та їхніми алгоритмами.
У відповідального ШІ є різні напрями. Справедливість — щоб рішення моделі не залежали від статі, віку, походження чи інших ознак, які не стосуються суті завдання. Приватність — щоб дані людей були захищені. Прозорість і пояснюваність — щоб можна було зрозуміти, як система побудована і чому вона ухвалила саме таке рішення. Особливо якщо від цього рішення залежить чиєсь життя.
Такі системи використовують у страхуванні, кредитуванні, відборі резюме, для рекомендацій щодо звільнення під заставу. Остаточне рішення начебто ухвалює людина, але на практиці вона майже завжди покладається на систему. Тому важливо розуміти її критерії: наприклад, чому я не пройшла відбір? Що не так із моїм резюме?
В УКУ ми дуже стараємося сформувати розуміння: що б ти не створював, відповідальність має залишатися на команді, яка це розробляє.
Поясніть простими словами: що досліджує ваша команда у проєкті FairForget і навіщо штучний інтелект учити «забувати»?
У FairForget ми досліджуємо, що відбувається з моделлю, коли змушуємо її «забути» стереотип: чи вона справді його позбувається і чи не з’являються нові перекоси.
Спочатку у співпраці з Нью-Йоркським університетом ми вивчали, як поєднати різні критерії справедливості. Наприклад, проводимо олімпіаду, щоб фінансово підтримати найкращих студентів. Але якщо всі переможці — хлопці? Або всі із сильних ліцеїв великих міст, а із сіл немає нікого? Можливо, потрібні квоти? Що більше критеріїв, то складніше знайти баланс. А деякі критерії справедливості взагалі неможливо виконати одночасно — доводиться обирати.
Потім на програму прийшла Вікторія Маковська, з якою ми тепер працюємо над FairForget. Вона хотіла займатися відповідальним ШІ й залишатися в Україні. Віка зосередилася на «забуванні» інформації моделями, я — на їхній справедливості. FairForget підтримала Women Led Science — спільна ініціатива INSCIENCE, Tokarev Foundation та STEM is FEM. Тож ми отримали нагоду працювати над проєктом, який обʼєднує обидві теми.
Навіщо взагалі вчити модель «забувати»? На її навчання витрачають багато ресурсів і часу. А потім може з’ясуватися, що туди потрапила інформація, якої там не має бути. Іноді цього вимагає закон — наприклад, людина має право попросити видалити свої дані. Повністю перенавчати модель дорого, тому шукають способи точково прибрати вплив цієї інформації.
Як спроба позбавити ШІ одного стереотипу може несподівано посилити інший?
Візьмімо стереотип, що ветерани психологічно нестійкі й тому їх не варто брати на роботу. Намагаємося змусити модель його «забути», а можемо отримати протилежне: вона вважатиме ветеранів найкращими кандидатами для будь-якого роботодавця й надаватиме перевагу лише їм.
А буває інакше: ми послаблюємо гендерний стереотип, а модель починає сильніше спиратися на віковий або просто гірше відповідає на будь-які запити про цю групу. Упередження не зникає, а змінює форму.
Це спрощені приклади. Упередження — не окремий факт, а цілий набір уявлень про певну групу людей. Ми хочемо перевірити, чи модель справді їх «забуває», а не створює новий перекіс.
Де жінки вже сьогодні можуть стикатися з упередженими рішеннями алгоритмів, навіть не здогадуючись про це?
Один із найпоширеніших прикладів — рекрутинг. Якщо компанія раніше частіше відбирала чоловіків, модель може засвоїти цей підхід і рідше пропускати жіночі резюме.
Упередження можуть бути в даних, на яких навчається модель, або виникати під час її створення. А можуть проявлятися вже під час використання? Система радить запросити жінку на співбесіду, але фахівчиня з підбору персоналу вирішує: «Я краще знаю» — і не запрошує. Натомість рекомендацію запросити чоловіка сприймає як підтвердження свого вибору.
Розробники намагаються зменшувати упередження. Приміром, перші моделі на запит «вісім професорів» могли зобразити вісьмох сивих чоловіків в окулярах.Тепер багато моделей намагаються показувати людей різного віку, статі й походження. Нам важливо, щоб користувачі, особливо молоде покоління, не сприймали один стереотипний образ як єдиний можливий.
Який практичний результат має дати FairForget і хто зможе користуватися створеними вашою командою інструментами?
Один із результатів — методологія, за допомогою якої можна перевіряти, чи модель справді «забула» стереотип і чи не виникли нові упередження. Нею зможуть користуватися науковці, зокрема дослідники у великих компаніях.
Також ми створили набір даних WarBias зі стереотипами щодо внутрішньо переміщених осіб і ветеранів. Зазвичай досліджують гендерні, етнічні чи вікові упередження, а ми вирішили розширити цей перелік. Обрали теми, важливі для України й знайомі іншим країнам. У Європі теж є упереджене ставлення до людей, які переїжджають із країн, де відбуваються воєнні конфлікти. Нам хочеться, щоб Україна сама виносила такі питання на міжнародний порядок денний і пропонувала нові дослідження.
Важлива й мова. У дослідженнях переважають англомовні дані, але стереотипи в різних мовах можуть проявлятися по-різному. Наприклад, англійське professor може стосуватися і жінки, і чоловіка, а в українській є фемінітиви. Тому ми досліджуємо упередження й українською.
Чи досі жінкам у математиці та дослідженнях ШІ доводиться докладати більше зусиль, щоб їх сприймали як рівних фахівчинь?
В Україні та за кордоном я не відчувала, що мене не сприймають як фахівчиню. Але зі стереотипами точно стикалася в дитинстві. Я виграла міську олімпіаду з математики, а хлопець, який теж представляв нашу школу, не пройшов. Учителька сказала: «Ти, звісно, молодець, але я все одно вважаю, що жінки не можуть займатися математикою і що він кращий».
Як ви самі користуєтеся штучним інтелектом і які завдання ніколи не погодилися б йому довірити?
Користуюся ШІ багато: вивчаю агентів, експериментую з локальними моделями. Найбільше працюю з Claude, а з текстами — у ChatGPT. Але дати агенту доступ до всього комп’ютера мені страшно. Не уявляю, щоб він сам відповідав на листи. Такий інструмент підключений лише в проєкті з кодом, але там я бачу зміни в кожному рядку й можу прийняти або відхилити їх.
Із листами англійською ШІ економить час: накидаю зміст, отримую чернетку, вичитую. Але помічаю, що самій писати вже важче, хочеться лише відредагувати готове. Починаю втрачати навичку писати з нуля. І це мене лякає.
У дослідженнях для мене важливий сам процес. Навіть коли очищуєш дані, помічаєш щось нове, ухвалюєш рішення й можеш обрати зовсім інший напрям роботи. Якщо отримуєш готовий результат, цього досвіду не набуваєш. Тому мені важливо зберігати самостійність у діях і рішеннях.